


Blocarea boturilor AI funcționează cel mai bine printr-o configurare pe mai multe niveluri. De obicei, o singură metodă nu este suficientă, deoarece unele crawlere respectă standardele publicate, iar altele nu. O configurație combinată care utilizează fișierul robots.txt, meta-etichete, antete HTTP, standarde mai noi precum TDMRep și filtrarea pe partea de server sau prin Cloudflare poate reduce accesul crawlerelor IA conforme și poate îngreuna scraping-ul pentru boții mai agresivi.
Acest subiect este util dacă publicați conținut original și doriți să limitați modul în care acesta este indexat sau reutilizat de sistemele de IA. Metodele de mai jos nu funcționează toate în același mod. Unele comunică preferințele dvs., în timp ce altele refuză în mod activ accesul.
Cuprins
Blocarea bot-urilor AI din panoul de control
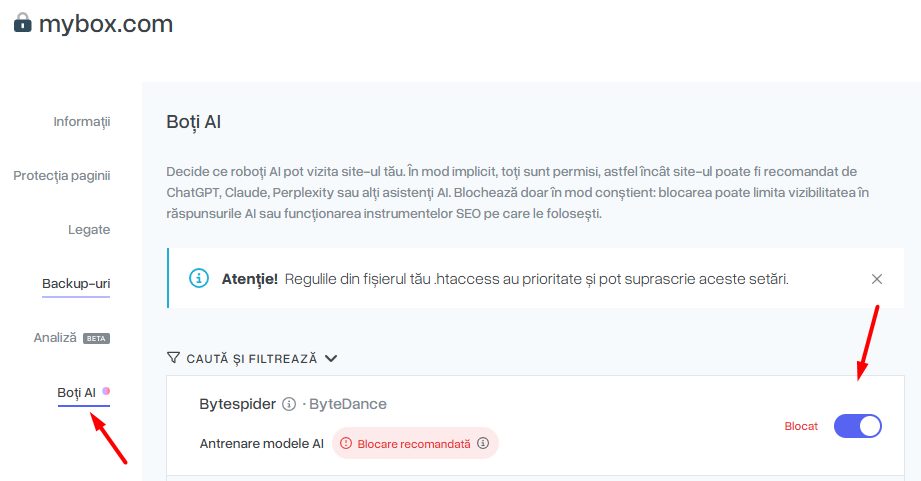

După ce vă autentificați în panoul de control, puteți utiliza sistemul integrat de blocare a roboților bazat pe IA. Dacă aveți nevoie de alte opțiuni sau doriți o protecție suplimentară, folosiți metodele de mai jos ca straturi separate.
Nivelul 1 – robots.txt pentru roboții AI cunoscuți
Fișierul robots.txt reprezintă modalitatea de bază de a comunica cu crawlerele. Acesta este plasat în directorul rădăcină al site-ului dvs. web. În acest fișier, puteți defini reguli care blochează anumite crawlere AI, precum GPTBot, ClaudeBot sau PerplexityBot. Această metodă funcționează pentru roboții care respectă standardul robots.txt, care include mulți furnizori de modele de mari dimensiuni.
O secțiune de exemplu din fișierul robots.txt care blochează anumiți roboți AI poate arăta astfel:
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: *
Disallow:
Cu această configurare, roboții AI enumerați nu ar trebui să indexeze site-ul dvs. Alți roboți pot avea în continuare acces deplin, dacă doriți acest lucru.
Nivelul 2 – meta-etichete și antete noai
O regulă din fișierul robots.txt nu specifică în mod direct că vă opuneți utilizării conținutului dvs. pentru antrenarea IA. În acest scop, unele site-uri utilizează, de asemenea, meta-etichete și antete X-Robots-Tag cu directive precum noai și noimageai. Acestea acționează ca un semnal suplimentar pentru instrumentele și crawlerele legate de IA, indicând faptul că nu permiteți acest tip de utilizare.
Pentru a aplica acest lucru la nivel global, puteți adăuga următoarea metaetichetă în secțiunea head a temei dvs. WordPress:
Dacă doriți să protejați doar o parte a site-ului, cum ar fi un director de conținut premium, puteți aplica un antet X-Robots-Tag pe partea de server. În Nginx, o configurație de exemplu poate arăta astfel:
location /premium/ {
 add_header X-Robots-Tag "noai, noimageai" always;
}
Cu această configurație, cererile către directorul premium primesc întotdeauna un antet care indică faptul că conținutul nu trebuie utilizat pentru antrenarea IA.
Stratul 3 – TDMRep, llms.txt și ai.txt
Se elaborează standarde mai noi pentru a ajuta proprietarii de site-uri web să-și exprime obiecțiile față de extragerea de text și date, ceea ce înseamnă prelucrarea la scară largă a conținutului de către instrumente și modele de IA. Un exemplu este TDMRep. Acesta utilizează o etichetă meta simplă sau un antet HTTP pentru a indica faptul că proprietarul site-ului nu permite acest tip de utilizare.
O etichetă meta TDMRep de exemplu arată astfel:
De asemenea, puteți adăuga antetul HTTP echivalent:
TDM-Reservation: 1
În același timp, fișiere precum llms.txt și ai.txt apar ca mecanisme similare. Acestea funcționează într-un mod comparabil cu fișierul robots.txt, dar pot descrie și utilizarea prevăzută a conținutului, nu doar accesul. În aceste fișiere, puteți specifica care furnizori de IA pot prelua conținut și în ce condiții.
Stratul 4 – blocarea la nivel de server și Cloudflare
Nu toți boții respectă regulile din fișierul robots.txt sau meta-directivele. Din acest motiv, poate fi util să adăugați o blocare mai strictă la nivel de server sau prin intermediul unui furnizor de CDN. În Cloudflare, de exemplu, puteți activa o regulă în secțiunea Securitate care blochează boții AI cunoscuți și filtrează o parte din acest trafic înainte ca acesta să ajungă pe site-ul dvs.
Dacă site-ul dvs. utilizează Apache, puteți folosi fișierul .htaccess pentru a returna un răspuns 403 pentru anumiți agenți de utilizator. O regulă de exemplu arată astfel:
RewriteEngine On

RewriteCond %{HTTP_USER_AGENT} GPTBot [NC,OR]
RewriteCond %{HTTP_USER_AGENT} ChatGPT-User [NC,OR]
RewriteCond %{HTTP_USER_AGENT} OAI-SearchBot [NC,OR]
RewriteCond %{HTTP_USER_AGENT} ClaudeBot [NC,OR]
RewriteCond %{HTTP_USER_AGENT} PerplexityBot [NC]
RewriteRule .* - [F,L]
Reguli similare pot fi adăugate în Nginx. Acest lucru vă permite să blocați solicitările provenite de la anumiți boți AI, chiar dacă aceștia ignoră fișierul robots.txt.
Nivelul 5 – condiții de utilizare, paywall și acces condiționat
Ultimul strat nu este în principal de natură tehnică. Se referă la regulile de utilizare a conținutului dvs. În condițiile de utilizare și în politica privind drepturile de autor, puteți preciza clar că nu permiteți utilizarea conținutului site-ului web pentru antrenarea modelelor de IA sau pentru scraping la scară largă. Acest lucru nu blochează automat boții, dar creează un temei juridic suplimentar în cazul în care cineva ignoră instrucțiunile dvs.
În cazul conținutului deosebit de valoros sau sensibil, puteți lua în considerare, de asemenea, limitarea accesului la utilizatorii autentificați, la abonamente sau la un sistem de acces cu plată. Majoritatea bot-urilor nu trec de aceste protecții, așa că nu au o cale tehnică directă către conținutul integral.
robots.txt, meta-etichete și blocări de server – care este diferența?
robots.txt
Comunică regulile de indexare către roboții care respectă standardul.
Meta-etichetele și anteturile X-Robots-Tag
Indică modul în care trebuie tratat conținutul, inclusiv directivele legate de utilizarea IA.
TDMRep, llms.txt și ai.txt
Exprimă preferințele de utilizare a conținutului în formate mai noi sau în curs de dezvoltare.
Reguli pe partea de server și Cloudflare
Resping sau filtrează în mod activ cererile, inclusiv cele provenite de la roboți care ignoră directivele publicate.
Cum să începeți în practică
O abordare pe mai multe niveluri oferă, de obicei, cele mai bune rezultate. Începeți cu un fișier robots.txt actualizat, care să includă reguli pentru roboții AI cunoscuți. Apoi adăugați o metaetichetă noai și noimageai în șablonul dvs. sau aplicați anteturi X-Robots-Tag la directoarele selectate.
Următorul pas poate fi TDMRep și, pe măsură ce aceste standarde se dezvoltă în continuare, llms.txt și ai.txt. În paralel, activați filtrarea traficului în instrumente precum Cloudflare sau configurați reguli simple în fișierul .htaccess. De asemenea, este util să completați configurarea tehnică cu termeni de utilizare clari și un model de acces bine definit pentru conținutul dvs. cel mai valoros.
Această configurare nu garantează o protecție completă. Cu toate acestea, ea îngreunează semnificativ preluarea conținutului de către IA la scară largă și oferă semnale clare cu privire la modul în care conținutul dvs. poate fi utilizat.